
|
|
|
|
|
|
|
|
La AI de PandoraLinux está en desarrollo
avanzado y podré ofrecer
|
|
La nueva sección está pensada para ayudar a utilizar la AI, ofreciendo ideas y soluciones propias o recibidas por correo electrónico. A medida que crezca el contenido, reconfiguraré la página para garantizar que todo sea claro y fácil de encontrar. Su actualización será semanal |
|
 |
|
|
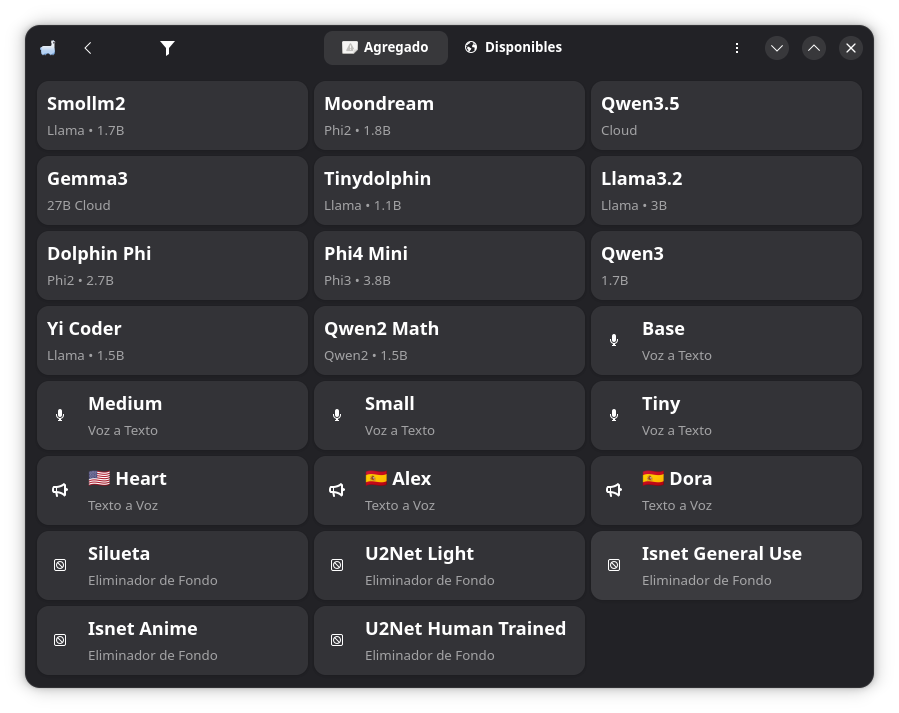
Breve resumen del uso de modelos de IA Los modelos de inteligencia artificial ya vienen con funcionalidad base gracias a un intenso entrenamiento previo realizado por sus desarrolladores, por lo que un usuario común no necesita entrenarlos desde cero. El entrenamiento previo lo hacen los creadores. Las empresas tecnológicas (como OpenAI, Google o Microsoft) entrenan los modelos desde cero. Alimentan al sistema con enormes cantidades de datos (textos, imágenes o códigos) usando miles de procesadores durante meses. El resultado es un modelo preentrenado que ya sabe hablar, redactar, programar o reconocer imágenes de forma general. Cuando abres un modelo de AI como Lama3.2, Phi4 mini o Qwen3.5 ya vienen con capacidades listas para usar. No lo estás entrenando en el sentido técnico, simplemente le das instrucciones (prompts) o contexto en el chat para guiar sus respuestas en una tarea específica. Cuándo sí se entrena o ajusta un modelo (Ajuste fino (fine-tuning)) es cuando empresas o desarrolladores pueden tomar un modelo ya listo y volver a entrenarlo con datos propios de un sector (por ejemplo, expedientes médicos o legales) para especializarlo. Algunas plataformas permiten subir documentos o definir reglas de comportamiento para que el sistema responda según ciertos lineamientos, pero esto modifica la interacción o la base de datos de apoyo, no la estructura central de la IA. En resumen vienen listos para funcionar, y tú solo interactúas con ellos sin necesidad de programar ni entrenar nada. |
|
|
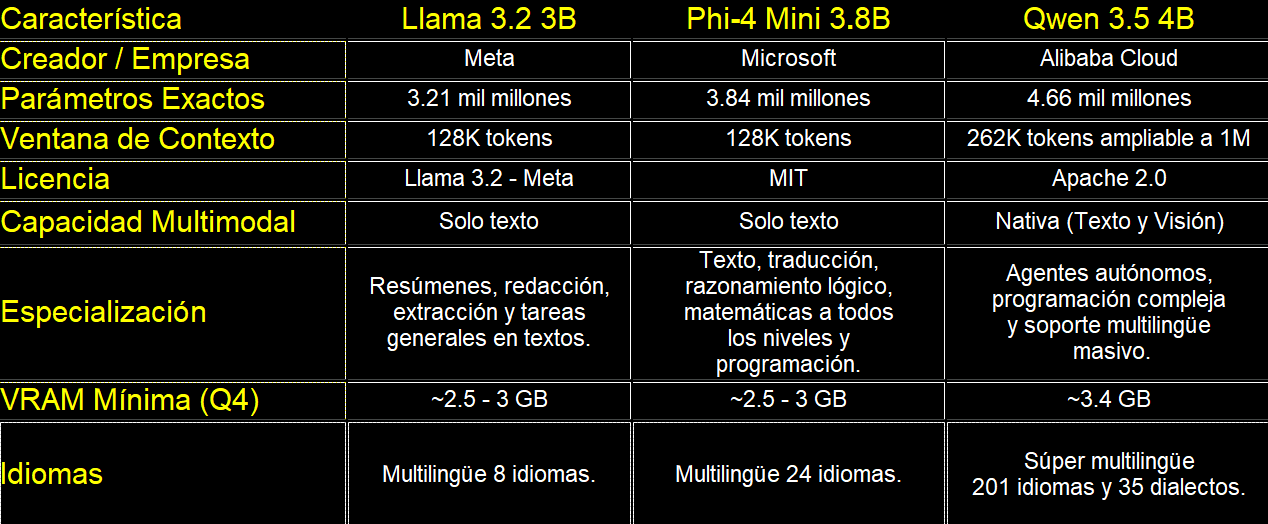
Rápido resumen de la IA de PandoraLinux El quinteto de la Inteligencia Artificial Local (Preinstalada). No existe un modelo único para todo. Por eso, PandoraLinux incluye la combinación perfecta de modelos pequeños pero ultra potentes optimizados para tu hardware: - Whisper: Es un sistema de reconocimiento automático del habla ( ASR ) desarrollado por OpenAI. Esta inteligencia artificial destaca por su capacidad de transcribir audio a texto. - Llama 3.2 3B: Tu asistente diario. Redacción fluida, traducción en segundos y respuestas rápidas con el sello de calidad de Meta. Es ligero, ideal si buscas la máxima velocidad de respuesta en tareas cotidianas de texto - Phi-4-mini 3.8B: Cerebro científico. Entrenado por Microsoft para dominar la programación, la lógica matemática y la resolución de problemas técnicos complejos gracias a su entrenamiento enfocado en datos sintéticos complejos. - Qwen3.5 4B: Cerebro científico con visión nativa y OCR. Desarrollado por Alibaba Cloud. Ofrece el rendimiento más robusto y versátil al incluir una ventana de contexto mucho más amplia, convirtiéndolo en un modelo "gigante" en cuerpo pequeño. - Tesseract OCR: Un motor de reconocimiento óptico de caracteres de código abierto, considerado el más preciso y popular del mundo. Originalmente desarrollado por Hewlett-Packard entre 1985 y 1995, mantenido, patrocinado por Google entre 2006 y 2018 y actualmente mantenido por una comunidad de código abierto. |
|
 |
|
|
Aclaración Al procesar los datos localmente, se garantiza la total confidencialidad de la información del usuario y se reduce la latencia, siendo ideales para equipos desconectados de internet. |
 |
|
|
|
 Whisper es un sistema de reconocimiento automático del habla ( ASR ) desarrollado por OpenAI. Esta inteligencia artificial destaca por su capacidad de transcribir audio a texto con una precisión muy alta, además de identificar idiomas y realizar traducciones directas al inglés. El modelo fue entrenado con un enorme conjunto de 680,000 horas de datos de audio multilingües recopilados de internet. Gracias a este volumen de información, es capaz de entender con facilidad diferentes acentos, lidiar con el ruido de fondo y comprender vocabulario técnico o jerga especializada. Funciona con alta fidelidad ( entre 80% y 99% de precisión dependiendo de la lengua ) ante condiciones de audio difíciles. Transmisión multilingüe Español Inglés Catalán Vasco Gallego Occitano Alemán Francés Italiano Portugués Rumano Neerlandés Holandés Sueco Danés Noruego Islandés Luxemburgués Ruso Polaco Ucraniano Checo Eslovaco Búlgaro Bielorruso Serbio Croata Esloveno Macedonio Bosnio Finés Estonio Húngaro Letón Lituano Griego Albanés Galés Gaélico escocés Bretón Latín Chino Mandarín Cantonés Japonés Coreano Mongol Tibetano Hindi Bengalí Panyabí Maratí Guyaratí Tamil Telugu Canarés Malayalam Nepalí Sindi Cingalés Sánscrito Asamés Dogri Maithili Konkaní Cachemiro Urdu Vietnamita Indonesio Tagalo/Filipino Tailandés Javanés Malayo Jemer Lao Birmano Sundanés Persa Pastún Tayiko Georgiano Armenio Azerbaiyano Turco Kazajo Uzbeko Turcomano Kirguís Tártaro Bashkir Chuvash Afrikáans Yidis Árabe Hebreo Amhárico Swahili Yoruba Zulú Shona Hausa Somalí Lingala Ganda Nyanja Malgache Fulani Maorí Hawaiano Guaraní |
|
 Llama3.2 3B es un modelo ligero de solo texto desarrollado por Meta. "Built with Llama" - Resumen de textos Condensa extensos historiales de chat, correos electrónicos o notas de reuniones locales. Procesa instrucciones detalladas en lenguaje natural para tareas como resúmenes, redacción y agentes conversacionales personalizados - Llamada a herramientas (Tool Calling) Ejecuta comandos para controlar aplicaciones de terceros, automatizar tareas del sistema o activar dispositivos del hogar inteligente. - Redacción y edición sobre la marcha Reescribe, corrige o cambia el tono de textos en asistentes de escritura móviles. - Seguimiento de instrucciones Atiende indicaciones de manera fluida gracias a una amplia ventana de contexto de hasta 128,000 tokens de entrada y salida combinados. - Generación multilingüe Maneja con gran precisión el procesamiento y traducción de texto en múltiples idiomas, soporta oficialmente 8 idiomas incluyendo un excelente rendimiento en español. Español Inglés Alemán Francés Italiano Portugués Hindi Tailandés Aunque solo tiene soporte oficial para 8 lenguas, Meta entrenó el modelo con una colección más amplia de datos, por lo que puede comprender o traducir de manera informal otros idiomas. - Rendimiento práctico fiable Aunque soporta los 128K tokens, los expertos recomiendan limitar el texto de entrada a unos 16.000 tokens (~12.000 palabras) para asegurar que el modelo no pierda detalles importantes ubicados en el centro del documento (fenómeno conocido como Lost in the Middle). |
|
 Phi4 mini de Microsoft es un Modelo de Lenguaje Pequeño (SLM) de 3.800 millones de parámetros diseñado para ofrecer un rendimiento de alta velocidad y baja latencia directamente en dispositivos locales. Razonamiento lógico, generación de código y procesamiento. - Resolución de problemas Descompone consultas complejas paso a paso (especialmente en sus variantes Reasoning o Flash-Reasoning). - Matemáticas avanzadas Resuelve problemas aritméticos, algebraicos y lógicos con una precisión que supera a otros modelos del doble de su tamaño. - Comprensión y análisis de código Genera, completa y audita código de programación (por ejemplo, en Python), haciéndolo ideal para autocompletado en tiempo real en entornos de desarrollo. - Interacción con herramientas externas Puede conectarse e interactuar de forma nativa con APIs, bases de datos y motores de búsqueda de Internet. - Automatización Ejecuta comandos estructurados basados en las intenciones del usuario para controlar herramientas de software o interactuar con dispositivos del hogar inteligente. - Análisis de documentos extensos Cuenta con una ventana de contexto de 128.000 tokens, lo que le permite procesar y resumir libros enteros, contratos legales o historiales de chat masivos sin perder el hilo. - Seguimiento estricto de instrucciones Está optimizado mediante técnicas de alineación para respetar formatos complejos como respuestas en JSON o estructuras específicas. - Traducción y redacción Gracias a un vocabulario expandido de 200.000 tokens, comprende y genera texto de forma fluida en 23 idiomas de forma oficial con mayor precisión que las versiones anteriores. Español Inglés Francés Alemán Italiano Japonés Coreano Finés Árabe Chino Checo Danés Holandés Hebreo Húngaro Noruego Polaco Portugués Ruso Sueco Tailandés Turco Ucraniano - Comprensión y análisis de código Genera, completa y audita código de programación (por ejemplo, en Python), haciéndolo ideal para autocompletado en tiempo real en entornos de desarrollo. Al tratarse de un modelo de lenguaje general de código abierto, Microsoft no publica una lista cerrada o restrictiva de lenguajes de programación compatibles. Esto se debe a que fue entrenado con un volumen masivo de datos que incluye 5 billones de tokens (5T tokens) procedentes de repositorios de código abierto de la web y datos sintéticos dense-reasoning. El modelo es intrínsecamente capaz de procesar e interpretar la sintaxis de prácticamente cualquier tecnología existente. 1. Lenguajes de Alta Competencia (Dominio Completo) • Python • JavaScript & TypeScript • C# • Java & Kotlin • C++ & C • Go (Golang) • Rust 2. Lenguajes Web, Datos y Automatización (Soporte Nativo) • SQL • Estructuras Web: HTML5, CSS3 • Formatos de Datos: JSON, XML, YAML, CSV • Automatización & Scripting: Bash / Shell Scripting (Linux), PowerShell (Windows) 3. Lenguajes Secundarios y Especializados (Comprensión y Sintaxis) • Lenguajes Funcionales o Estadísticos: R, Ruby, PHP, Swift (iOS), Scala, Haskell, Perl, Julia, Dart (Flutter). • Infraestructura como Código (IaC): Terraform, Dockerfiles, manifiestos de Kubernetes. • Markdown e Informes: Markdown (.md), LaTeX. |
|
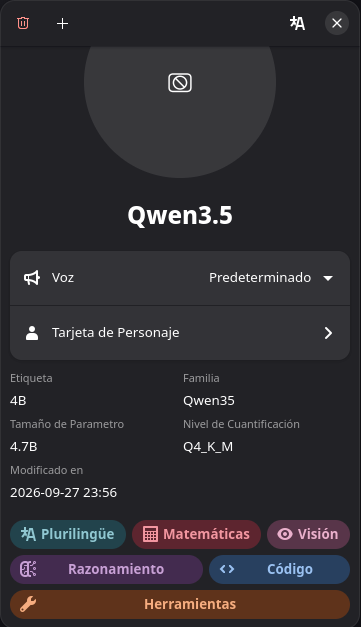 Qwen3.5 4B es un modelo multimodal compacto de 4.000 millones de parámetros desarrollado por Alibaba Cloud. Pese a su reducido tamaño destaca por integrar opciones que antes solo estaban disponibles en modelos de gran tamaño. 1. Base Multimodal Nativa (Visión y Video) - Comprensión de imágenes: Gracias a su arquitectura integrada (early fusion), procesa de forma nativa texto e imágenes simultáneamente. Puede identificar objetos, leer texto en documentos mediante OCR avanzado, resolver problemas visuales matemáticos y comprender mapas o diagramas. - Comprensión de video: Cuenta con la capacidad de analizar clips de video a nivel de API para describir escenas, acciones y expresiones con gran precisión. 2. Razonamiento Complejo e Integrado (Thinking Mode) - Cadenas de pensamiento (CoT): Integra el modo de pensamiento híbrido de la generación Qwen. Esto le permite "pensar" antes de responder, desglosando problemas matemáticos, lógicos y científicos complejos paso a paso antes de emitir la solución final. 3. Capacidades Agénticas y Uso de Herramientas - Llamada de funciones en tiempo real (Tool Calling): Es uno de los primeros modelos pequeños capaz de invocar y ejecutar herramientas externas de forma fiable (como realizar búsquedas web o ejecutar scripts) de forma autónoma mientras procesa su razonamiento (thinking). Esto lo convierte en un motor ideal para agentes de IA autónomos y ligeros. 4. Excelente base científica y matemática: La arquitectura Qwen está fuertemente optimizada para tareas de razonamiento lógico, matemáticas y resolución de problemas científicos. Para un nivel escolar (primaria y secundaria), sus explicaciones conceptuales y resolución de tareas son muy precisas. 5. Procesamiento de Textos Ultra Largos - Ventana de contexto masiva: De forma nativa soporta 262.144 tokens, los cuales son extensibles hasta 1 millón de tokens. Esto le permite analizar libros enteros, documentación técnica gigantesca o historiales de conversación muy largos con un consumo de memoria optimizado. 6. Cuenta con un soporte masivo: - Abarca 201 idiomas y dialectos globales en formato de texto. Su vocabulario expandido (de 248.000 tokens) le permite procesar con alta precisión no solo los idiomas comerciales principales, sino también lenguas regionales, minoritarias y variantes locales. - Idiomas Europeos y Regionales (Dominio Alto): Español (variantes de España y toda Latinoamérica) - Cooficiales España: Catalán, Gallego, Asturiano y Vasco (Euskera) Chino (Simplificado y Tradicional) Inglés (Estados Unidos, Reino Unido, Australia, etc.) Japonés Coreano Alemán Francés Portugués (Brasil y Portugal) Ruso Árabe (estándar moderno y variantes del Golfo o Egipto) - Lenguas cooficiales y regionales: - Europa Occidental: Italiano Holandés (Neerlandés) Irlandés Escocés Bretón Galés - Europa del Norte: Danés Sueco Noruego Finlandés Islandés - Europa Central y del Este: Polaco Checo Eslovaco Húngaro Rumano Búlgaro Ucraniano Bielorruso Croata Bosnio Serbio Esloveno Albanés Macedonio Letón Estonio Lituano - Idiomas Asiáticos y del Medio Oriente (Dominio Alto a Medio): - Sudeste Asiático: Vietnamita Tailandés Indonesio Malayo Tagalo (Filipino) Cebuano Javanés Jemer Laosiano Birmano - Sur de Asia: Hindi Urdu Bengalí Panyabí Maratí Guyaratí Tamil Télugu Canarés (Kannada) Malayalam Sánscrito Nepalí - Asia Central y Medio Oriente: Persa (Farsi) Turco Kurdo Hebreo Kazajo Kirguís Uzbiko Pastún Turcomano Azerí Armenio - Idiomas de África, América y de Nicho (Dominio Funcional): Swahili Afrikáans Amhárico Yoruba Igbo Zulú Xhosa Somalí Hausa Malgache - Lenguas de Oceanía e Islas: Hawaiano Fijiano Samoano Maorí - Lenguas Indígenas Americanas. Comprensión funcional de lenguas con presencia digital como el: Quechua Guaraní Náhuatl Aimara - Dialectos Chinos: Cantonés Min del sur Hakka Mandarín Taiwanés 7. Programación y Desarrollo de Software (Coding) - Generación de código autónomo: Es altamente competente en la creación de aplicaciones funcionales completas (como calculadoras, relojes o páginas web dinámicas). - Depuración y optimización: Puede leer estructuras de código, identificar errores (debugging) y refactorizar software eficientemente en múltiples lenguajes de programación. Está entrenado con un corpus masivo multilingüe y de código que le permite entender y procesar prácticamente cualquier lenguaje de programación convencional, académico o de nicho (más de 90 en total). Lenguajes de Máximo Dominio (Strong) Son los lenguajes principales con los que el modelo fue entrenado de forma intensiva. En ellos puede generar código complejo desde cero, estructurar arquitecturas completas y realizar debugging avanzado: Python (su lenguaje con mayor tasa de acierto y optimización) JavaScript (Vanilla, ES6+) TypeScript Java C++ Go (Golang) Rust SQL (dialectos ANSI, MySQL, PostgreSQL, SQLite, T-SQL, PL/SQL) Lenguajes con Buen Dominio (Good). Lenguajes comerciales y de infraestructura donde su rendimiento es altamente fiable para la mayoría de las tareas de desarrollo habituales: Ruby PHP Swift Kotlin Scala Shell / Bash Scripting C# (C-Sharp) C HTML5 y CSS3 (incluyendo preprocesadores como SASS y LESS) Lenguajes Funcionales, Científicos y de Nicho (Capable). Lenguajes que el modelo comprende perfectamente a nivel lógico, permitiendo traducir código, corregir errores sintácticos o generar scripts específicos: R (Análisis estadístico) Dart (Especialmente para frameworks como Flutter) Lua Perl Haskell MATLAB y Julia Objective-C PowerShell Visual Basic .NET / VBA Assembly (Asm) (arquitecturas x86, x64, ARM) Fortran y COBOL (Sistemas legados) Groovy, Clojure, Elixir y Erlang F# OCaml Lenguajes de Configuración, Marcado e Infraestructura (DevOps) Además de la lógica pura, procesa sin problemas formatos de datos y herramientas de infraestructura como código (IaC): YAML y JSON XML y TOML Markdown (MD) GraphQL Terraform (HCL) Dockerfiles y manifiestos de Kubernetes LaTeX (para documentación matemática y científica) |
|
|
|
|
  Es el motor de reconocimiento óptico de caracteres (OCR) de código abierto más popular y potente del mundo. Sirve principalmente para extraer el texto contenido en imágenes, fotos, capturas de pantalla o PDF escaneados, convirtiéndolos en texto plano editable. El motor de reconocimiento óptico de caracteres (OCR) Tesseract ha pasado por varias etapas de desarrollo a lo largo de su historia: - Hewlett-Packard (1985–1994) En 2005, HP liberó el código fuente. - Google (2006–2018) Google patrocinó y lideró el desarrollo del proyecto durante más de una década. Durante esta etapa, rediseñaron el motor incorporando redes neuronales (LSTM) en su versión 4 para mejorar drásticamente la precisión. - Comunidad de Código Abierto (2019–Presente) Actualmente, Tesseract es un proyecto completamente mantenido por una comunidad global de desarrolladores independientes en su repositorio oficial de GitHub. - Visión Artificial y Procesamiento de Imágenes Segmentación de texto Capacidad para analizar la estructura de una imagen y separar bloques de texto, párrafos, líneas y palabras aisladas antes de procesarlas. - Análisis de diseño estructural (Layout Analysis) Identifica la orientación de la página y distingue entre columnas, tablas y zonas sin texto para leer en el orden correcto. - Predicción secuencial de caracteres Gracias a sus redes neuronales LSTM, predice la letra o palabra que sigue basándose en el contexto visual inmediato, lo que mejora la precisión en textos dañados o de baja calidad. - Procesamiento y Extracción de Datos Digitalización y accesibilidad Competencia para transformar píxeles e información visual caótica en texto digital estructurado codificado (ASCII/Unicode) ejecutable para motores de búsqueda. - Reconocimiento de Patrones y Aprendizaje Profundo Detección lingüística multilingüe Competencia para reconocer y procesar caracteres en más de 100 idiomas simultáneamente, incluyendo escrituras complejas y de derecha a izquierda y 35 escrituras directamente "out of the box". El motor utiliza los códigos estandarizados de tres letras ISO 639-2 para identificar cada paquete de idioma. Idiomas Principales y Europeos: • spa – Español • eng – Inglés • fra – Francés • deu – Alemán • ita – Italiano • por – Portugués • cat – Catalán • eus – Euskera / Vasco • glg – Gallego • nld – Neerlandés / Holandés • rus – Ruso • ell – Griego moderno • ces – Checo • pol – Polaco • dan – Danés • fin – Finés / Finlandés • swe – Sueco • nor – Noruego • ron – Rumano • bul – Búlgaro • hrv – Croata • hun – Húngaro • ukr – Ucraniano • bel – Bielorruso • lav – Letón • lit – Lituano • est – Estonio • slk – Eslovaco • slv – Esloveno • srp – Serbio • sqi – Albanés • mkd – Macedonio • mlt – Maltés • isl – Islandés • gle – Irlandés • cym – Galés • gla – Gaélico escocés • fao – Feroés • ltz – Luxemburgués • fry – Frisón Idiomas Asiáticos: • chi_sim – Chino simplificado • chi_tra – Chino tradicional • jpn – Japonés • kor – Coreano • hin – Hindi • ara – Árabe • heb – Hebreo • fas – Persa • tur – Turco • ind – Indonesio • msa – Malayo • tha – Tailandés • vie – Vietnamita • tgl – Tagalo • ben – Bengalí • tam – Tamil • tel – Telugu • kan – Canarés / Kannada • mal – Malayalam • guj – Guyaratí • ori – Odia / Oriya • pan – Panyabí / Punjabi • sin – Cingalés • mya – Birmano • khm – Jemer • lao – Lao • kat – Georgiano • hye – Armenio • aze – Azerbaiyano • uzb – Uzbeko • kaz – Kazajo • tgk – Tayiko • kir – Kirguís • mon – Mongol • mar – Maratí • nep – Nepalí • urd – Urdu • snd – Sindhi • pus – Pastún • div – Dhivehi / Maldivo • dzo – Dzongkha • bod – Tibetano • syr – Siriaco • uighur – Uigur • jav – Javanés • sun – Sundanés Idiomas Africanos y de Oriente Medio: • afr – Afrikáans • amh – Amhárico • tir – Tigriña • som – Somalí • swa – Swahili • yor – Yoruba • ibo – Igbo • hau – Hausa • mlg – Malgache Idiomas Indígenas y Regionales Americanos / Otros: • chr – Cheroqui • iku – Inuktitut • hat – Criollo haitiano • fil – Filipino • ceb – Cebuano • mri – Maorí • ton – Tongano • smo – Samoano Idiomas Antiguos o Históricos: • grc – Griego antiguo • lat – Latín • enm – Inglés medio • frm – Francés medio • frk – Frankish (Fráncico antiguo) • ita_old – Italiano antiguo • spa_old – Español antiguo |
|
|
|
 |
|